Fachbeitrag
„Das ist doch ein Web-Framework!“ – Warum ich Automatisierungen mit Django entwickle
Automatisierung braucht zuerst eine Anwendung: Daten, Oberfläche, Rechte, Protokoll. Warum ich dafür auf Django setze, von SQLite bis Celery, und wann ich davon abrate.
Wenn ich erzähle, dass ich viele meiner Automatisierungen mit Django entwickle, bekomme ich gelegentlich die Frage gestellt:
„Warum Django? Das ist doch eigentlich ein Web-Framework.“
Ja, absolut. Aber genau das ist für mich einer der größten Vorteile. Wenn es um Automatisierung geht, denken viele zunächst an Werkzeuge wie n8n, Make oder Zapier. Damit lassen sich verschiedene Dienste miteinander verbinden und ganze Arbeitsabläufe automatisieren, häufig sogar ohne selbst viel programmieren zu müssen. Ich finde solche Werkzeuge durchaus sinnvoll und nutze sie auch selbst.
Allerdings möchte ich bei vielen meiner Projekte nicht einfach nur Informationen von einem Programm ins nächste übertragen. Mich interessiert vielmehr, wie sich ganze Arbeitsabläufe in Unternehmen digital abbilden und anschließend automatisieren lassen. Und dafür brauche ich oft mehr als eine Abfolge einzelner Aktionen. Ich brauche eine Anwendung, in der Menschen arbeiten können, Informationen strukturiert gespeichert werden und verschiedene Prozesse miteinander verbunden sind.
Genau hier spielt Django für mich seine Stärken aus.
Vor der Automatisierung kommt die Digitalisierung
Stellen wir uns einmal einen Reinigungsdienst vor, der für verschiedene Hausverwaltungen Treppenhäuser und andere Gebäudebereiche reinigt. Eine Hausverwaltung schreibt eine E-Mail:
„Das Treppenhaus in Haus 12 wurde am Dienstag nicht gereinigt.“
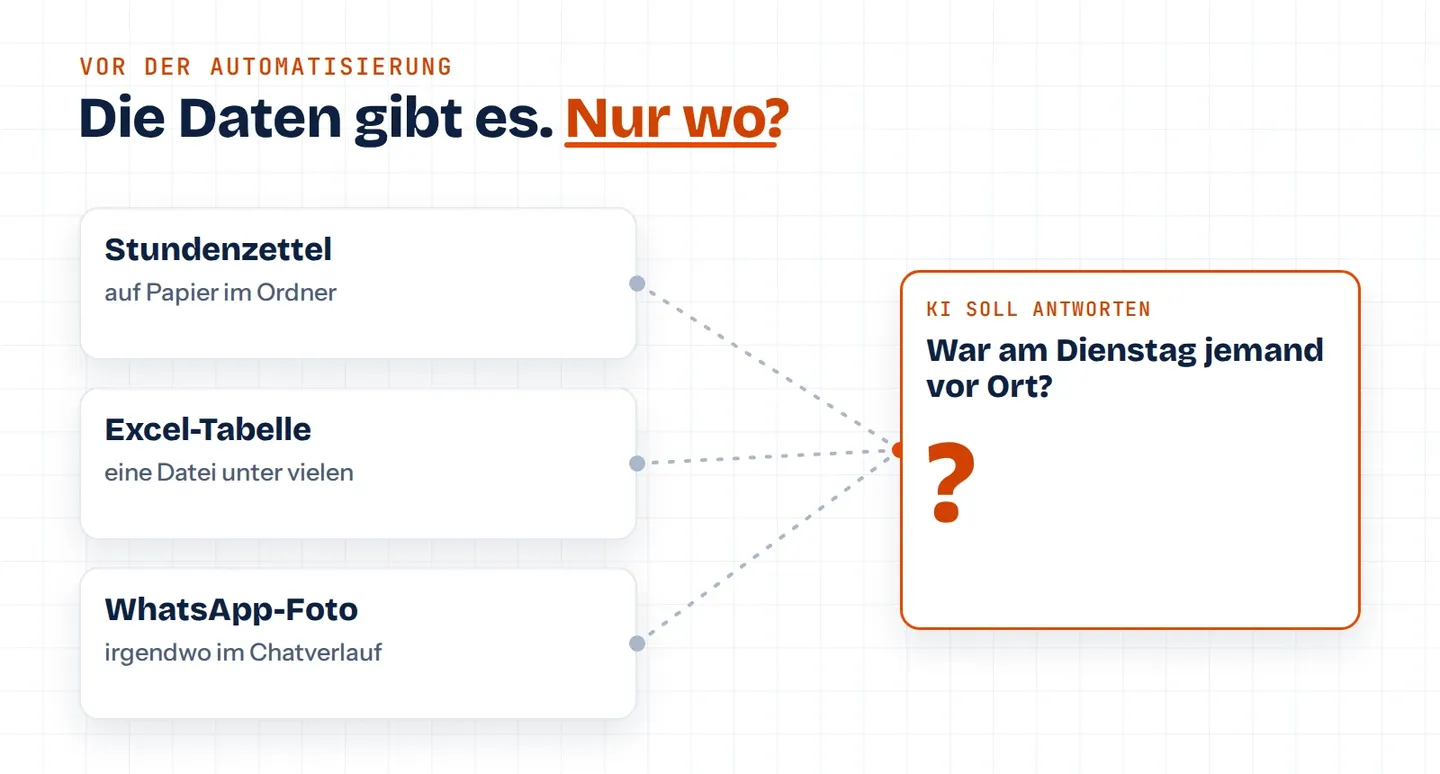
Jetzt könnte ich eine KI einsetzen, die diese Nachricht liest und innerhalb weniger Sekunden eine freundliche Antwort formuliert. Technisch wäre das heute keine besonders große Herausforderung. Aber was soll die KI eigentlich antworten? Sie weiß schließlich nicht, ob an diesem Dienstag tatsächlich jemand vor Ort war.
Vielleicht steht der Einsatz auf einem Stundenzettel. Vielleicht wurde er in einer Excel-Tabelle dokumentiert. Möglicherweise hat die Reinigungskraft auch ein Foto per WhatsApp geschickt. Die Informationen existieren also vielleicht schon, aber sie liegen an verschiedenen Orten und sind nicht ohne Weiteres miteinander verknüpft. Und genau das ist ein Problem, das mir bei der Beschäftigung mit Unternehmensabläufen immer wieder begegnet.
Bevor wir Prozesse sinnvoll automatisieren können, müssen die benötigten Informationen erst einmal zuverlässig und möglichst strukturiert verfügbar sein.
Deshalb würde ich bei unserem Beispiel gar nicht damit anfangen, eine KI für die Beantwortung von Reklamationen einzurichten. Ich würde zunächst verstehen wollen, wie das Unternehmen eigentlich arbeitet. Wie werden Einsätze geplant? Wie dokumentieren die Mitarbeiter ihre Arbeit? Wo landen diese Informationen? Und was passiert, wenn sich ein Auftraggeber beschwert? Erst dann würde ich überlegen, wie wir diesen Ablauf digital abbilden können.
Aus einzelnen Arbeitsschritten wird eine Anwendung
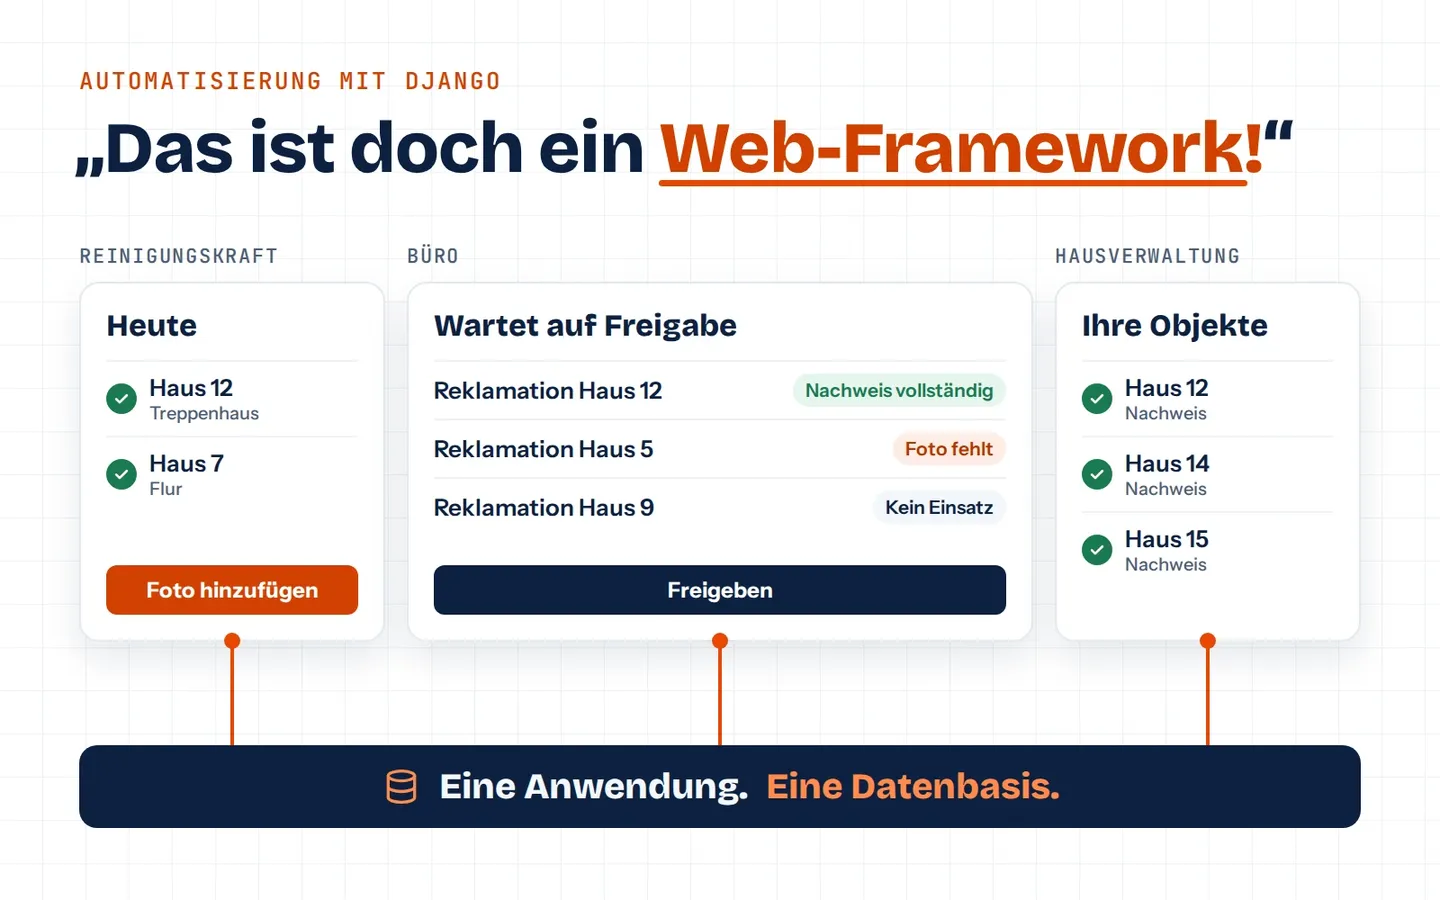
Meine Idee wäre in diesem Fall eine gemeinsame Webanwendung, in der alle Beteiligten arbeiten können, allerdings mit unterschiedlichen Zugängen und Funktionen. Die Reinigungskraft öffnet morgens auf ihrem Smartphone eine Übersicht ihrer geplanten Einsätze. Dort sieht sie, welche Objekte anstehen, welche Aufgaben erledigt werden müssen und welche Besonderheiten es möglicherweise gibt. Nach der Reinigung hakt sie ihre Checkliste ab und kann bei Bedarf ein Foto als Nachweis hinterlegen.
Das Büro bekommt eine andere Oberfläche. Hier werden Einsätze geplant, Mitarbeiter zugeteilt, offene Aufgaben kontrolliert und eingehende Reklamationen bearbeitet. Statt Informationen aus verschiedenen Tabellen, E-Mails und Chatverläufen zusammenzusuchen, stehen sie direkt beim jeweiligen Vorgang.
Und auch die Hausverwaltung könnte einen eigenen Zugang erhalten. Dort sieht sie ihre Objekte, die durchgeführten Einsätze und die dazugehörigen Nachweise, selbstverständlich ohne Zugriff auf die Daten anderer Auftraggeber. Wir haben also drei unterschiedliche Nutzergruppen mit ganz verschiedenen Anforderungen.
Aber alle arbeiten auf derselben Datengrundlage.
Und niemand muss dafür eine komplizierte Software installieren. Ein Browser auf dem Smartphone, Tablet oder Computer reicht aus. Genau solche Anwendungen entwickle ich gerne, weil sich dadurch häufig mehrere Probleme gleichzeitig lösen lassen, die vorher gar nicht unbedingt als zusammenhängend wahrgenommen wurden.
Jetzt können wir anfangen, wirklich zu automatisieren
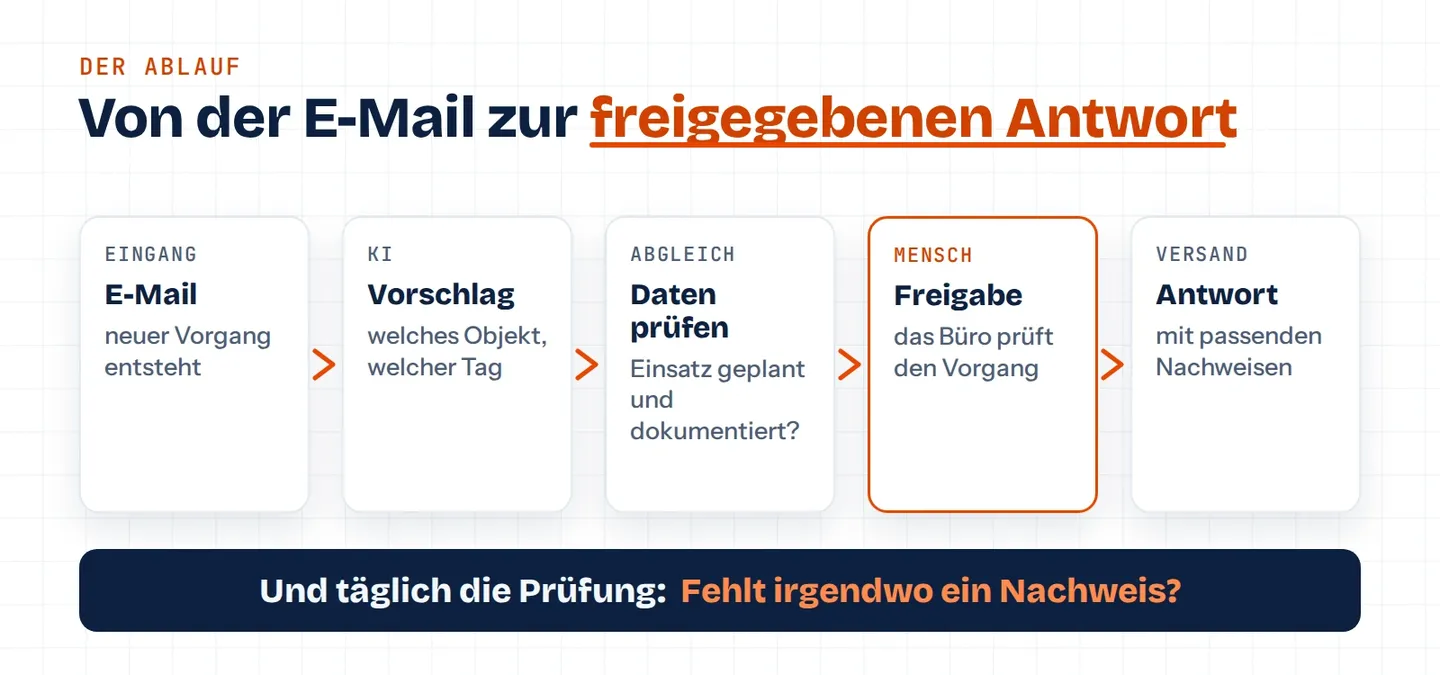
Kommen wir zurück zu unserer Reklamation. Die Hausverwaltung schickt eine E-Mail, weil angeblich ein Treppenhaus nicht gereinigt wurde. Unsere Anwendung kann diese Nachricht automatisch empfangen und einen neuen Vorgang anlegen.
Eine KI analysiert den Inhalt und schlägt vor, um welches Objekt und welchen Tag es geht. Anschließend prüft die Anwendung anhand der vorhandenen Daten, ob für diesen Tag ein Einsatz geplant und dokumentiert wurde. Vielleicht ist alles vollständig erfasst und es liegen sogar Fotos vor. Vielleicht fehlt ein Nachweis. Oder es wurde tatsächlich kein Einsatz dokumentiert.
Das Büro bekommt die Reklamation zusammen mit den passenden Informationen angezeigt und kann den Vorgang prüfen. Die Anwendung könnte sogar schon eine passende Antwort vorbereiten. Nach der Freigabe durch einen Mitarbeiter werden die erforderlichen Nachweise zusammengestellt und die Antwort verschickt. Das spart Zeit, reduziert Sucharbeit und sorgt dafür, dass Informationen nicht mehr mühsam aus verschiedenen Quellen zusammengesucht werden müssen.
Aber damit wäre ich noch lange nicht zufrieden. Denn wenn wir ohnehin wissen, welche Einsätze geplant sind und welche tatsächlich dokumentiert wurden, stellt sich doch eine ganz andere Frage:
Warum warten wir überhaupt, bis sich jemand beschwert?
Unsere Anwendung könnte regelmäßig prüfen, ob geplante Einsätze ohne Dokumentation geblieben sind. Fehlt ein Nachweis, wird das Büro darauf aufmerksam gemacht. Vielleicht wurde die Reinigung einfach noch nicht bestätigt, vielleicht ist jemand krank geworden oder ein Einsatz wurde tatsächlich vergessen. Statt erst auf eine Reklamation reagieren zu müssen, kann das Unternehmen jetzt selbst aktiv werden.
Und das ist für mich einer der interessantesten Aspekte solcher Lösungen. Wir automatisieren nicht einfach nur einen bestehenden Arbeitsschritt, sondern können den gesamten Ablauf verbessern.
Warum ich dafür gerne Django verwende
Natürlich ließe sich ein Teil dieser Funktionen auch mit anderen Technologien umsetzen. Warum also ausgerechnet Django? Für mich ist es vor allem die Kombination aus einem ausgereiften Web-Framework, Python und der Möglichkeit, Anwendungen strukturiert und modular aufzubauen.
Daten und ihre Zusammenhänge
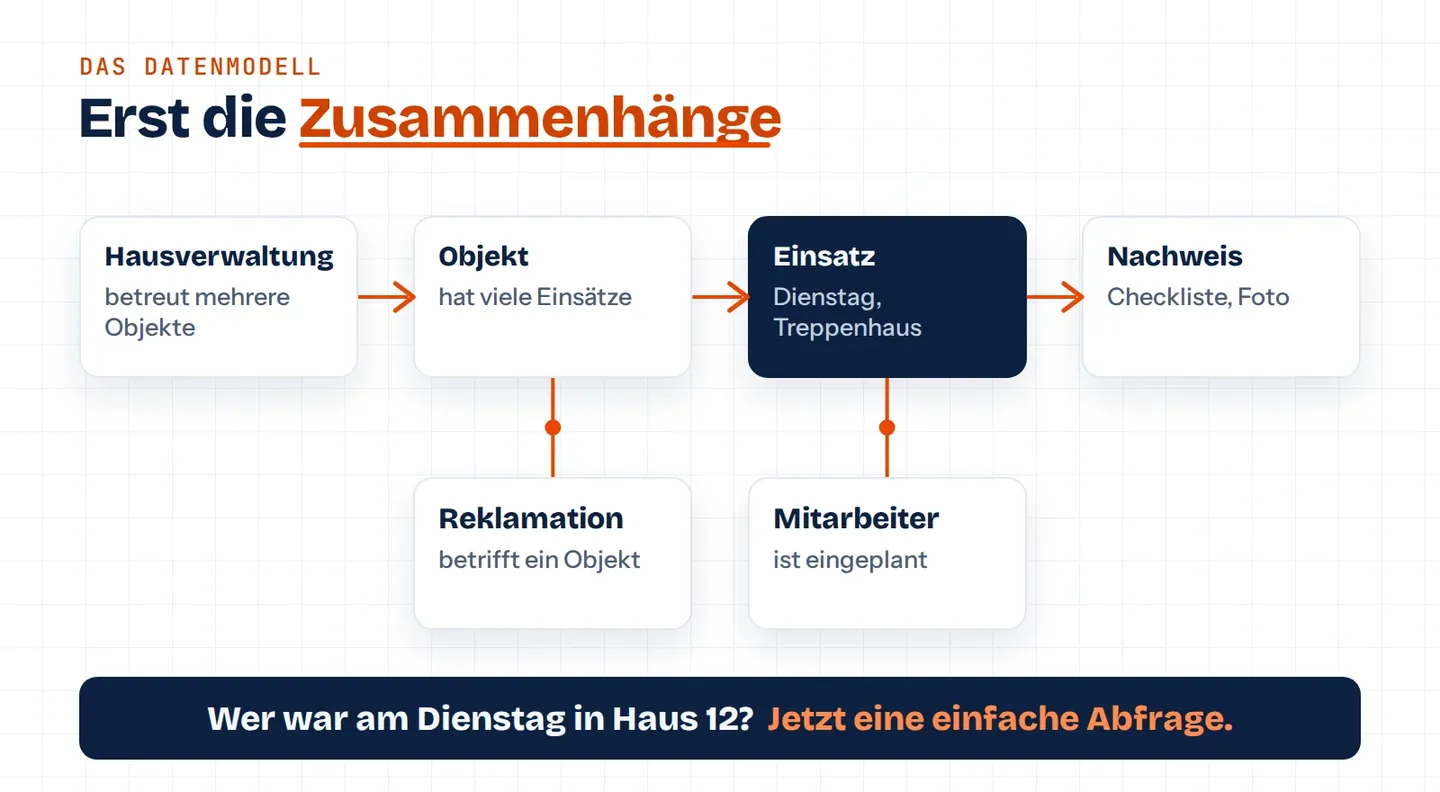
Mit dem ORM von Django kann ich direkt in Python definieren, welche Daten unsere Anwendung verwalten soll und wie diese miteinander zusammenhängen. In unserem Beispiel wären das etwa Kunden, Objekte, Mitarbeiter, geplante Einsätze, Checklisten und Reklamationen. Eine Hausverwaltung betreut mehrere Objekte. Ein Objekt hat viele Einsätze. Ein Einsatz gehört zu einem Mitarbeiter und kann verschiedene Nachweise enthalten.
Solche Beziehungen lassen sich sauber in einem Datenmodell abbilden. Das klingt zunächst vielleicht wenig spektakulär, ist aber die Grundlage für fast alles, was wir anschließend automatisieren möchten. Denn erst wenn die Anwendung diese Zusammenhänge kennt, kann sie zuverlässig Fragen beantworten wie: Welcher Mitarbeiter war am Dienstag in Haus 12 eingeplant? Wurde der Einsatz dokumentiert? Gibt es dazu einen Nachweis? Und wer muss informiert werden, wenn etwas fehlt?
Benutzer und Berechtigungen
Django bringt bereits eine Benutzerverwaltung sowie ein System für Gruppen und Berechtigungen mit. Darauf aufbauend kann ich festlegen, welche Funktionen ein Benutzer verwenden darf und auf welche Informationen er zugreifen kann.
Die Reinigungskraft benötigt schließlich andere Funktionen als das Büro. Und eine Hausverwaltung darf selbstverständlich nur die Daten ihrer eigenen Objekte sehen. Solche objektbezogenen Zugriffsregeln muss ich für die jeweilige Anwendung entwickeln und testen, aber Django liefert mir dafür bereits eine sehr gute Grundlage.
Oberflächen, die zum Arbeitsalltag passen
Dieser Punkt ist mir besonders wichtig. Eine Automatisierung kann technisch noch so beeindruckend sein. Wenn die Menschen, die damit arbeiten sollen, nicht mit der Anwendung zurechtkommen, wird sie wenig Nutzen bringen. Deshalb möchte ich Oberflächen entwickeln, die sich am tatsächlichen Arbeitsablauf orientieren.
Die Reinigungskraft braucht auf ihrem Smartphone keine umfangreiche Verwaltungssoftware, sondern eine einfache Übersicht ihrer heutigen Aufgaben und eine Möglichkeit, diese schnell zu dokumentieren. Das Büro benötigt dagegen deutlich mehr Informationen, Filtermöglichkeiten und Verwaltungsfunktionen.
Mit Djangos Template-System kann ich solche Oberflächen direkt auf Basis der vorhandenen Daten erstellen. In Kombination mit Werkzeugen wie htmx lassen sich auch interaktive Funktionen umsetzen, ohne dass ich dafür jedes Mal ein umfangreiches JavaScript-Frontend entwickeln muss. Und genau das gefällt mir: Ich kann mich stärker auf die eigentliche Anwendung konzentrieren.
Viele Grundlagen sind bereits vorhanden
Ein weiterer Vorteil ist die Menge an Funktionen, die Django schon mitbringt. Mit dem Admin-Bereich kann ich beispielsweise Daten verwalten, häufig noch bevor die eigentliche Benutzeroberfläche vollständig entwickelt ist. Datenbankmigrationen ermöglichen kontrollierte Änderungen an den Datenmodellen. Hinzu kommen Funktionen für Benutzerauthentifizierung, Formulare, Mehrsprachigkeit, Tests und verschiedene Sicherheitsmechanismen.
Natürlich entsteht dadurch nicht automatisch eine sichere und zuverlässige Anwendung. Dafür sind weiterhin eine saubere Implementierung, die richtige Konfiguration und entsprechende Tests notwendig. Aber ich muss viele grundlegende Funktionen nicht erst selbst entwickeln.
Und dann ist da natürlich noch Python. Ob PDF-Verarbeitung, Excel-Dateien, Bilderkennung, Schnittstellen oder KI: Für unglaublich viele Aufgaben gibt es bereits ausgereifte Bibliotheken. Dadurch kann ich verschiedenste Funktionen in einer gemeinsamen Anwendung zusammenführen, ohne ständig zwischen völlig unterschiedlichen Technologien wechseln zu müssen.
Klein anfangen und bei Bedarf wachsen
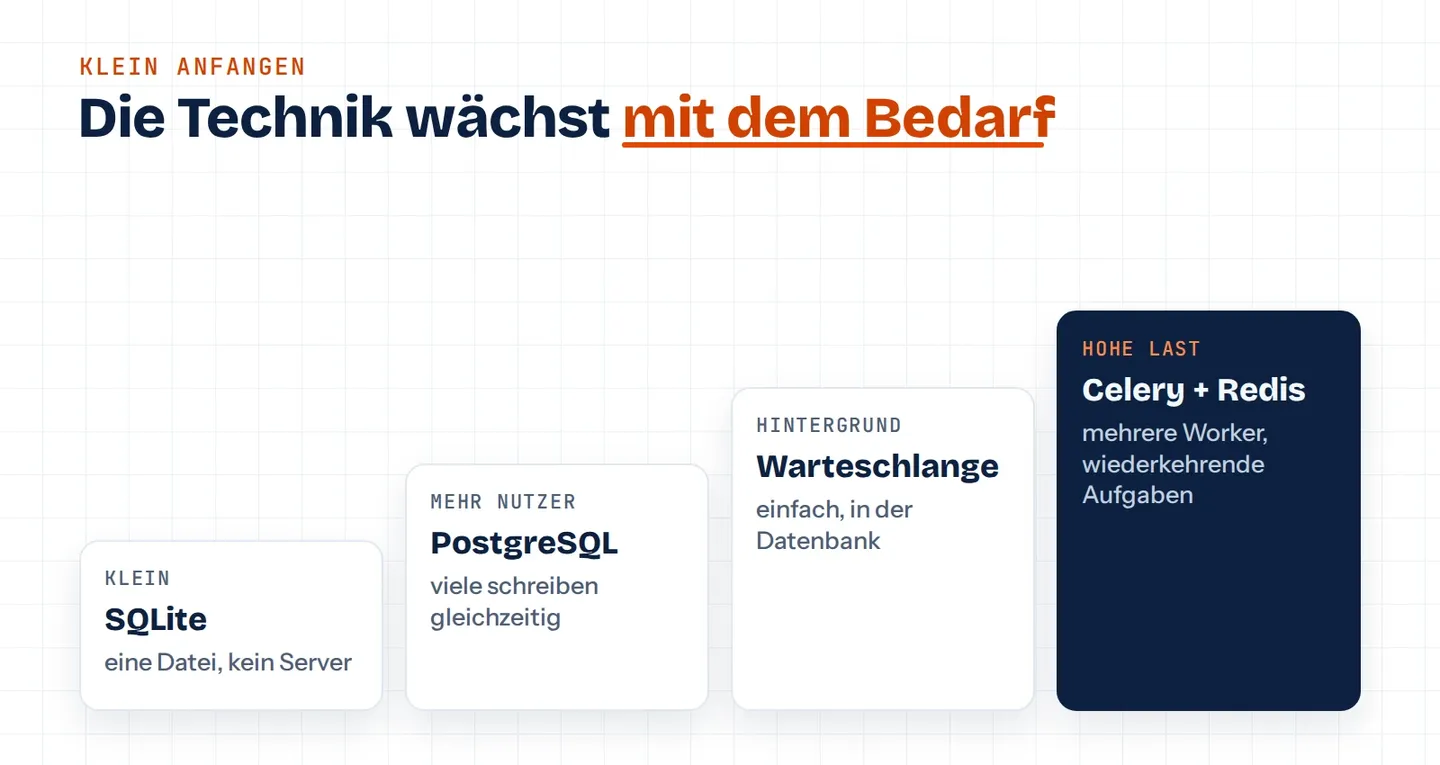
Nicht jede Anwendung benötigt von Anfang an eine große Infrastruktur. Wenn ein kleines Unternehmen beispielsweise ein internes Werkzeug für einen einzelnen Arbeitsbereich benötigt, wäre es wenig sinnvoll, dafür direkt mehrere Datenbankserver, Warteschlangen und Hintergrundprozesse aufzubauen. Deshalb gefällt mir, dass ich mit Django vergleichsweise einfach anfangen und die Architektur später erweitern kann.
Von SQLite zu PostgreSQL
Für kleine Anwendungen kann SQLite vollkommen ausreichen. Die Datenbank liegt in einer Datei, es muss kein zusätzlicher Datenbankserver betrieben werden und der Aufwand bleibt überschaubar. Auch mehrere Benutzer sind damit grundsätzlich möglich. Bei vielen gleichzeitigen Schreibzugriffen stößt SQLite allerdings schneller an Grenzen.
Für größere Anwendungen mit mehreren gleichzeitig arbeitenden Benutzern setze ich deshalb bevorzugt auf PostgreSQL. PostgreSQL bietet umfangreiche Möglichkeiten zur gleichzeitigen Verarbeitung, Datenintegrität und Abfrage komplexerer Datenbestände. Django unterstützt beide Datenbanken, sodass sich große Teile des Anwendungscodes weiterverwenden lassen. Ein Wechsel muss natürlich vorbereitet und getestet werden, aber ich bin nicht von Anfang an auf eine bestimmte Größenordnung festgelegt.
Hintergrundaufgaben mit Celery und Redis
Ein ähnliches Prinzip gilt für Aufgaben, die nicht unmittelbar während einer Webanfrage erledigt werden müssen. Wenn ein Mitarbeiter beispielsweise einen umfangreichen Bericht erstellt, mehrere Dokumente verarbeitet oder eine KI-Analyse startet, soll er nicht minutenlang auf eine Antwort seines Browsers warten müssen. Solche Aufgaben lasse ich im Hintergrund ausführen.
Für kleinere Anwendungen kann dafür bereits eine einfache datenbankgestützte Warteschlange ausreichen. Werden die Anforderungen größer, verwende ich beispielsweise Celery mit Redis. Damit lassen sich Aufgaben an verschiedene Worker verteilen und bei Bedarf mehrere Prozesse parallel ausführen. Auch wiederkehrende Aufgaben sind möglich, etwa die tägliche Überprüfung aller geplanten Reinigungseinsätze.
Was mir daran gefällt, ist die Möglichkeit, klein anzufangen und die Infrastruktur an den tatsächlichen Bedarf anzupassen. Ich muss nicht für jedes kleine Kundenprojekt dieselbe komplexe Architektur betreiben.
Einmal entwickeln, mehrfach verwenden
Das ist tatsächlich einer der Bereiche, mit denen ich mich in letzter Zeit besonders intensiv beschäftigt habe. Denn mein Ziel ist nicht, einfach nur einzelne Anwendungen zu entwickeln. Ich möchte einen Entwicklungsprozess schaffen, mit dem ich individuelle Software möglichst effizient erstellen, bereitstellen und langfristig warten kann. Dafür habe ich mir eine eigene Entwicklungs- und Bereitstellungsumgebung aufgebaut.
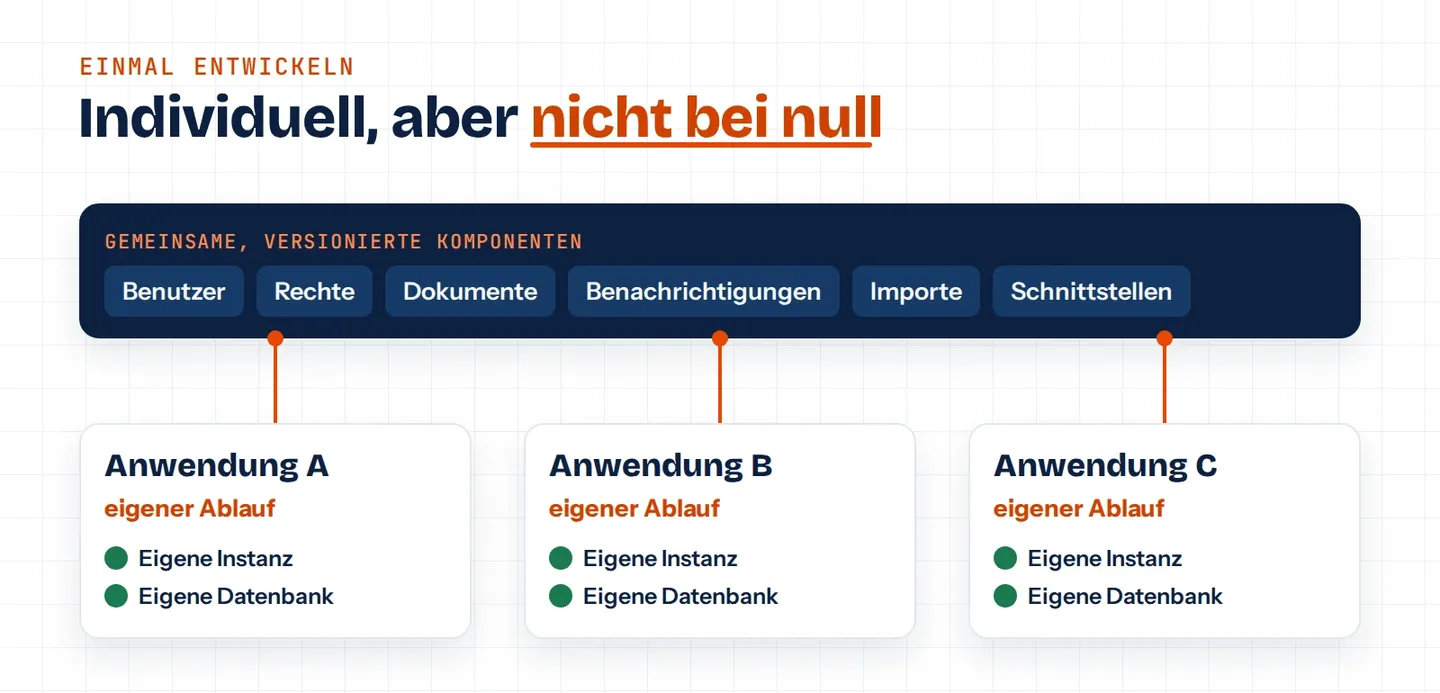
Ein wichtiger Bestandteil davon sind wiederverwendbare Django-Komponenten. Bestimmte Funktionen benötige ich schließlich in vielen Anwendungen. Benutzerverwaltung, Berechtigungen, Dokumentenverarbeitung, Benachrichtigungen, Importe oder Schnittstellen sind keine Besonderheiten eines einzelnen Kundenprojekts. Warum sollte ich sie also jedes Mal komplett neu entwickeln?
Stattdessen entwickle ich gemeinsame Komponenten, die ich versionieren, erweitern und in unterschiedlichen Anwendungen wiederverwenden kann. Die eigentliche Individualentwicklung konzentriert sich dadurch stärker auf die speziellen Anforderungen und Arbeitsabläufe des jeweiligen Kunden.
Die Anwendung ist individuell. Aber ich muss dafür nicht jedes Mal bei null anfangen.
Das ist für mich ein ziemlich entscheidender Unterschied. Gerade durch die Fortschritte bei KI-gestützter Softwareentwicklung lässt sich heute sehr schnell neuer Programmcode erstellen. Das finde ich großartig und nutze diese Möglichkeiten selbst intensiv.
Allerdings möchte ich nicht irgendwann hundert verschiedene Anwendungen betreuen, bei denen dieselben grundlegenden Funktionen hundertmal unterschiedlich implementiert wurden. Das würde die Wartung auf Dauer unnötig kompliziert machen. Deshalb lege ich großen Wert auf gemeinsame Komponenten, klare Schnittstellen und eine möglichst einheitliche Architektur.
Von der Entwicklung bis zum Betrieb
Auch die Bereitstellung habe ich weitgehend standardisiert. Mit Docker lassen sich die Anwendung und ihre benötigten Dienste in Containern betreiben. Dadurch kann ich Software auf unterschiedlichen Servern ausführen, beispielsweise auf gemieteter Infrastruktur oder bei entsprechenden Anforderungen auch lokal beim Kunden.
Meine Kundenanwendungen können als getrennte Instanzen mit eigenen Datenbanken betrieben werden. Die Bereitstellung und Aktualisierung erfolgen dabei über standardisierte Abläufe, sodass ich nicht jedes Mal eine komplette Serverumgebung manuell einrichten muss.
Für mich ist das ein wichtiger Teil des gesamten Konzepts. Denn ich möchte nicht nur Software schnell entwickeln können. Ich möchte sie anschließend auch zuverlässig betreiben und langfristig weiterentwickeln. Mehr über den technischen Aufbau beschreibe ich unter Technik und Arbeitsweise.
Warum ich trotzdem nicht alles mit Django entwickle
Bei aller Begeisterung für diesen Ansatz ist Django natürlich nicht immer die beste Wahl. Wenn ich lediglich zwei bestehende Cloud-Dienste miteinander verbinden möchte, ist dafür häufig keine eigene Webanwendung notwendig. Genau für solche Aufgaben eignen sich Werkzeuge wie n8n, Make oder Zapier hervorragend.
Auch bei einfachen Aufgaben, die regelmäßig ausgeführt werden sollen, reicht manchmal schon ein kleines Python-Skript. Und wenn ich zunächst herausfinden möchte, ob eine bestimmte Automatisierung überhaupt einen Nutzen bringt, ist ein schnell umgesetzter Prototyp möglicherweise sinnvoller als eine vollständige Anwendung.
Eine Django-Anwendung muss schließlich entwickelt, betrieben und gewartet werden. Das verursacht Aufwand und Kosten, die zum tatsächlichen Nutzen passen müssen. Ich betrachte Workflow-Werkzeuge und eigene Anwendungen deshalb auch nicht als Konkurrenten. Im Gegenteil. Eine Django-Anwendung kann beispielsweise über eine Schnittstelle mit n8n kommunizieren. So lassen sich beide Ansätze sinnvoll miteinander verbinden.
Für mich ist nicht entscheidend, welches Werkzeug gerade besonders beliebt ist. Entscheidend ist, welches Problem ich damit lösen möchte.
Und jetzt kommt für mich einer der spannendsten Punkte: Was machen wir mit den Daten?
Bis hierhin haben wir mit unserer Anwendung bereits einiges erreicht. Wir haben die Einsatzplanung und Dokumentation digitalisiert, Informationen an einem zentralen Ort zusammengeführt und mehrere Arbeitsschritte automatisiert. Aber dabei ist noch etwas passiert, das ich besonders interessant finde.
Wir haben ganz nebenbei eine Datenbasis geschaffen, die vorher überhaupt nicht in dieser Form existiert hat.
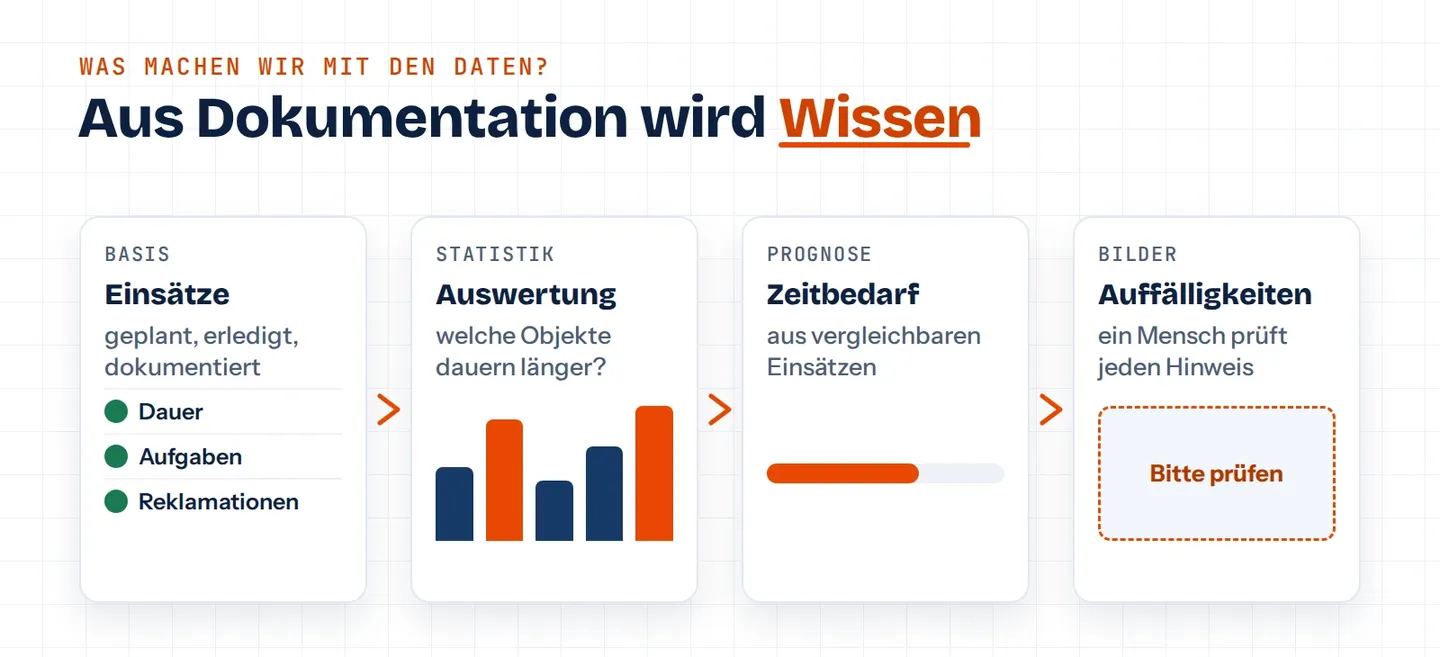
Bleiben wir bei unserem Reinigungsdienst. Mit jedem dokumentierten Einsatz entstehen neue Informationen. Wir wissen beispielsweise, wann ein Einsatz geplant war, wie lange er tatsächlich gedauert hat, welche Arbeiten erledigt wurden und ob es anschließend Reklamationen gab. Nach einigen Monaten oder Jahren können daraus ziemlich interessante Erkenntnisse entstehen.
Von einfachen Auswertungen zu besseren Entscheidungen
Zunächst müssen wir dafür überhaupt keine künstliche Intelligenz einsetzen. Schon einfache Statistiken können einen großen Mehrwert bieten. Vielleicht stellen wir fest, dass bestimmte Objekte regelmäßig mehr Zeit benötigen als ursprünglich eingeplant. Oder dass Reklamationen besonders häufig auftreten, wenn zwischen zwei Reinigungen ein längerer Zeitraum liegt. Möglicherweise erkennen wir auch, dass bestimmte Aufgaben saisonabhängig deutlich mehr Aufwand verursachen.
Mit solchen Informationen kann das Unternehmen seine Planung verbessern, Angebote realistischer kalkulieren und Probleme frühzeitig erkennen. Das ist bereits ein großer Fortschritt gegenüber einer Situation, in der die meisten Informationen auf Papier oder in einzelnen Tabellen verteilt sind. Aber wir können natürlich noch einen Schritt weitergehen.
Können wir mit den Daten eigene KI-Modelle trainieren?
Ja, grundsätzlich schon. Und genau diese Möglichkeit finde ich besonders spannend. Stellen wir uns beispielsweise vor, wir möchten möglichst genau vorhersagen, wie lange ein bestimmter Reinigungseinsatz dauern wird. Dafür könnten wir Daten aus vergangenen Einsätzen verwenden. Wie groß ist das Objekt? Welche Arbeiten müssen erledigt werden? Wie häufig wird gereinigt? Wie lange haben vergleichbare Einsätze in der Vergangenheit gedauert?
Mit ausreichend vielen und qualitativ guten Daten könnten wir ein Modell trainieren, das daraus den voraussichtlichen Zeitbedarf für neue Einsätze abschätzt. Die Anwendung könnte diese Vorhersagen anschließend direkt bei der Einsatzplanung berücksichtigen. Natürlich muss das nicht unbedingt ein neuronales Netz sein. Gerade bei solchen strukturierten Daten können klassische Machine-Learning-Verfahren oft schon hervorragende Ergebnisse liefern. Aber das Prinzip bleibt gleich:
Unsere Anwendung verwendet nicht mehr nur fest definierte Regeln, sondern kann mithilfe historischer Daten Vorhersagen über zukünftige Vorgänge treffen.
Ein neuronales Netz zur Bilderkennung
Ein anderes Beispiel wären die Fotos, die unsere Reinigungskräfte zur Dokumentation ihrer Arbeit aufnehmen. Angenommen, über einen längeren Zeitraum entstehen viele Bilder von gereinigten Bereichen, Abfallbehältern oder anderen regelmäßig kontrollierten Einrichtungen.
Mit ausreichend geeigneten und entsprechend gekennzeichneten Bildern könnten wir ein neuronales Netz darauf trainieren, bestimmte sichtbare Auffälligkeiten zu erkennen. Vielleicht soll das Modell feststellen, ob ein Abfallbehälter offensichtlich überfüllt ist oder ob auf einem Foto eine größere Verschmutzung zu erkennen ist. Die Anwendung könnte auffällige Bilder dann automatisch markieren, damit ein Mitarbeiter sie überprüft.
Natürlich würde ich mich bei solchen Entscheidungen nicht blind auf ein KI-Modell verlassen. Fotos zeigen immer nur einen Ausschnitt, und eine automatische Bilderkennung kann Fehler machen. Aber als zusätzliche Unterstützung bei der Qualitätskontrolle könnte so etwas durchaus interessant sein. Und wenn man sich überlegt, dass unsere Anwendung ursprünglich nur dazu dienen sollte, Reinigungseinsätze zu dokumentieren und Reklamationen einfacher zu bearbeiten, ist das doch eine ziemlich spannende Entwicklung.
Nicht jede Auswertung braucht ein eigenes KI-Modell
Dabei möchte ich einen Punkt ausdrücklich betonen. Nur weil wir Daten sammeln, bedeutet das nicht, dass wir unbedingt ein eigenes neuronales Netz trainieren müssen. Oft sind einfache Auswertungen, nachvollziehbare Regeln oder klassische Prognoseverfahren vollkommen ausreichend.
Und manchmal ist es sinnvoller, bereits vorhandene KI-Modelle mit den eigenen Unternehmensdaten arbeiten zu lassen, anstatt selbst ein Modell zu trainieren. Entscheidend ist immer, welchen Nutzen die jeweilige Lösung tatsächlich bietet.
Außerdem brauchen wir für das Training eigener Modelle ausreichend gute und geeignete Daten. Bei kleineren Unternehmen ist das nicht immer gegeben, und häufig müssen Daten zunächst bereinigt oder für das Training entsprechend aufbereitet werden.
Auch der Datenschutz muss von Anfang an berücksichtigt werden. Insbesondere personenbezogene Daten dürfen nicht einfach deshalb für das KI-Training verwendet werden, weil sie technisch verfügbar sind. Dafür braucht es einen klaren Zweck und eine geeignete rechtliche Grundlage.
Deshalb würde ich die Anwendung möglichst früh so gestalten, dass sinnvolle Auswertungen möglich sind, ohne unnötig Daten zu sammeln. Und genau das ist ein weiterer Vorteil, wenn ich eine Anwendung selbst entwickle: Ich kann bereits beim Entwurf des Datenmodells darüber nachdenken, welche Informationen später tatsächlich hilfreich sein könnten.
Aus einem kleinen Werkzeug kann langfristig viel mehr werden
Wenn ich mir diesen gesamten Ablauf anschaue, finde ich vor allem die Entwicklung interessant. Wir beginnen mit einem ganz konkreten Problem. Ein Reinigungsdienst möchte seine Einsätze besser dokumentieren und Reklamationen einfacher bearbeiten. Dafür entwickeln wir zunächst eine Anwendung, die den Arbeitsalltag der Mitarbeiter erleichtert. Anschließend automatisieren wir einzelne Arbeitsschritte.
Und weil die Anwendung dabei kontinuierlich strukturierte Daten erfasst, können wir diese später auswerten und möglicherweise sogar für lernende Systeme nutzen. Aus einer einfachen Einsatzdokumentation könnte langfristig eine Anwendung werden, die bei der Planung unterstützt, mögliche Engpässe frühzeitig erkennt und dabei hilft, Arbeitsabläufe kontinuierlich zu verbessern.
Natürlich wird nicht jedes kleine Projekt irgendwann ein komplexes KI-System benötigen. Aber allein die Möglichkeit, eine Anwendung schrittweise in diese Richtung weiterzuentwickeln, finde ich enorm interessant.
Für mich ist das der eigentliche Reiz an der Kombination aus individueller Softwareentwicklung, Automatisierung und künstlicher Intelligenz.
Wir lösen nicht nur ein einzelnes Problem, sondern schaffen eine Grundlage, auf der sich mit der Zeit weitere Möglichkeiten ergeben können.
Mein Fazit
Wenn ich heute mit einem Unternehmen über Digitalisierung spreche, interessieren mich zunächst weniger die eingesetzten Programme als die tatsächlichen Arbeitsabläufe. Wo werden Informationen mehrfach eingetragen? Welche Aufgaben wiederholen sich ständig? Wo müssen Mitarbeiter Informationen mühsam zusammensuchen? Und welche Dinge funktionieren eigentlich nur deshalb, weil sich jeden Tag jemand darum kümmert? Gerade in kleineren Unternehmen gibt es davon erstaunlich viele.
Durch moderne Entwicklungswerkzeuge und KI wird es zunehmend wirtschaftlich interessant, auch für solche individuellen Probleme eigene Softwarelösungen zu entwickeln. Django ist für mich dabei ein vielseitiges Werkzeug, mit dem ich die Digitalisierung, Automatisierung und spätere Weiterentwicklung solcher Prozesse in einer gemeinsamen Anwendung verbinden kann.
Dabei geht es mir nicht darum, möglichst viel Technik einzusetzen. Manchmal ist eine einfache Datenbank mit einer vernünftigen Oberfläche schon eine enorme Verbesserung. Manchmal entsteht daraus später eine Automatisierung, die jeden Tag mehrere Stunden Arbeit spart. Und vielleicht eröffnet die entstandene Datenbasis irgendwann Möglichkeiten, an die zu Beginn noch niemand gedacht hat.
Genau das begeistert mich an individueller Softwareentwicklung: Man beginnt mit einem konkreten Problem aus dem Arbeitsalltag und kann daraus Schritt für Schritt etwas entwickeln, das weit über die ursprüngliche Aufgabe hinausgeht.
Gibt es in Ihrem Unternehmen Abläufe, die unnötig viel Zeit kosten?
Vielleicht werden auch bei Ihnen Informationen mehrfach eingetragen, Aufgaben manuell koordiniert oder Daten aus verschiedenen Programmen zusammengesucht. Nicht immer braucht es dafür eine große Softwarelösung. Manchmal reichen ein kleines Werkzeug, eine Schnittstelle oder eine überschaubare Automatisierung.
Wenn Sie möchten, können Sie mir Ihren Ablauf über meine Ersteinschätzung beschreiben. Ich schaue mir gerne an, welche Möglichkeiten es gibt und ob sich eine individuelle Lösung für Ihr Unternehmen wirtschaftlich lohnt.